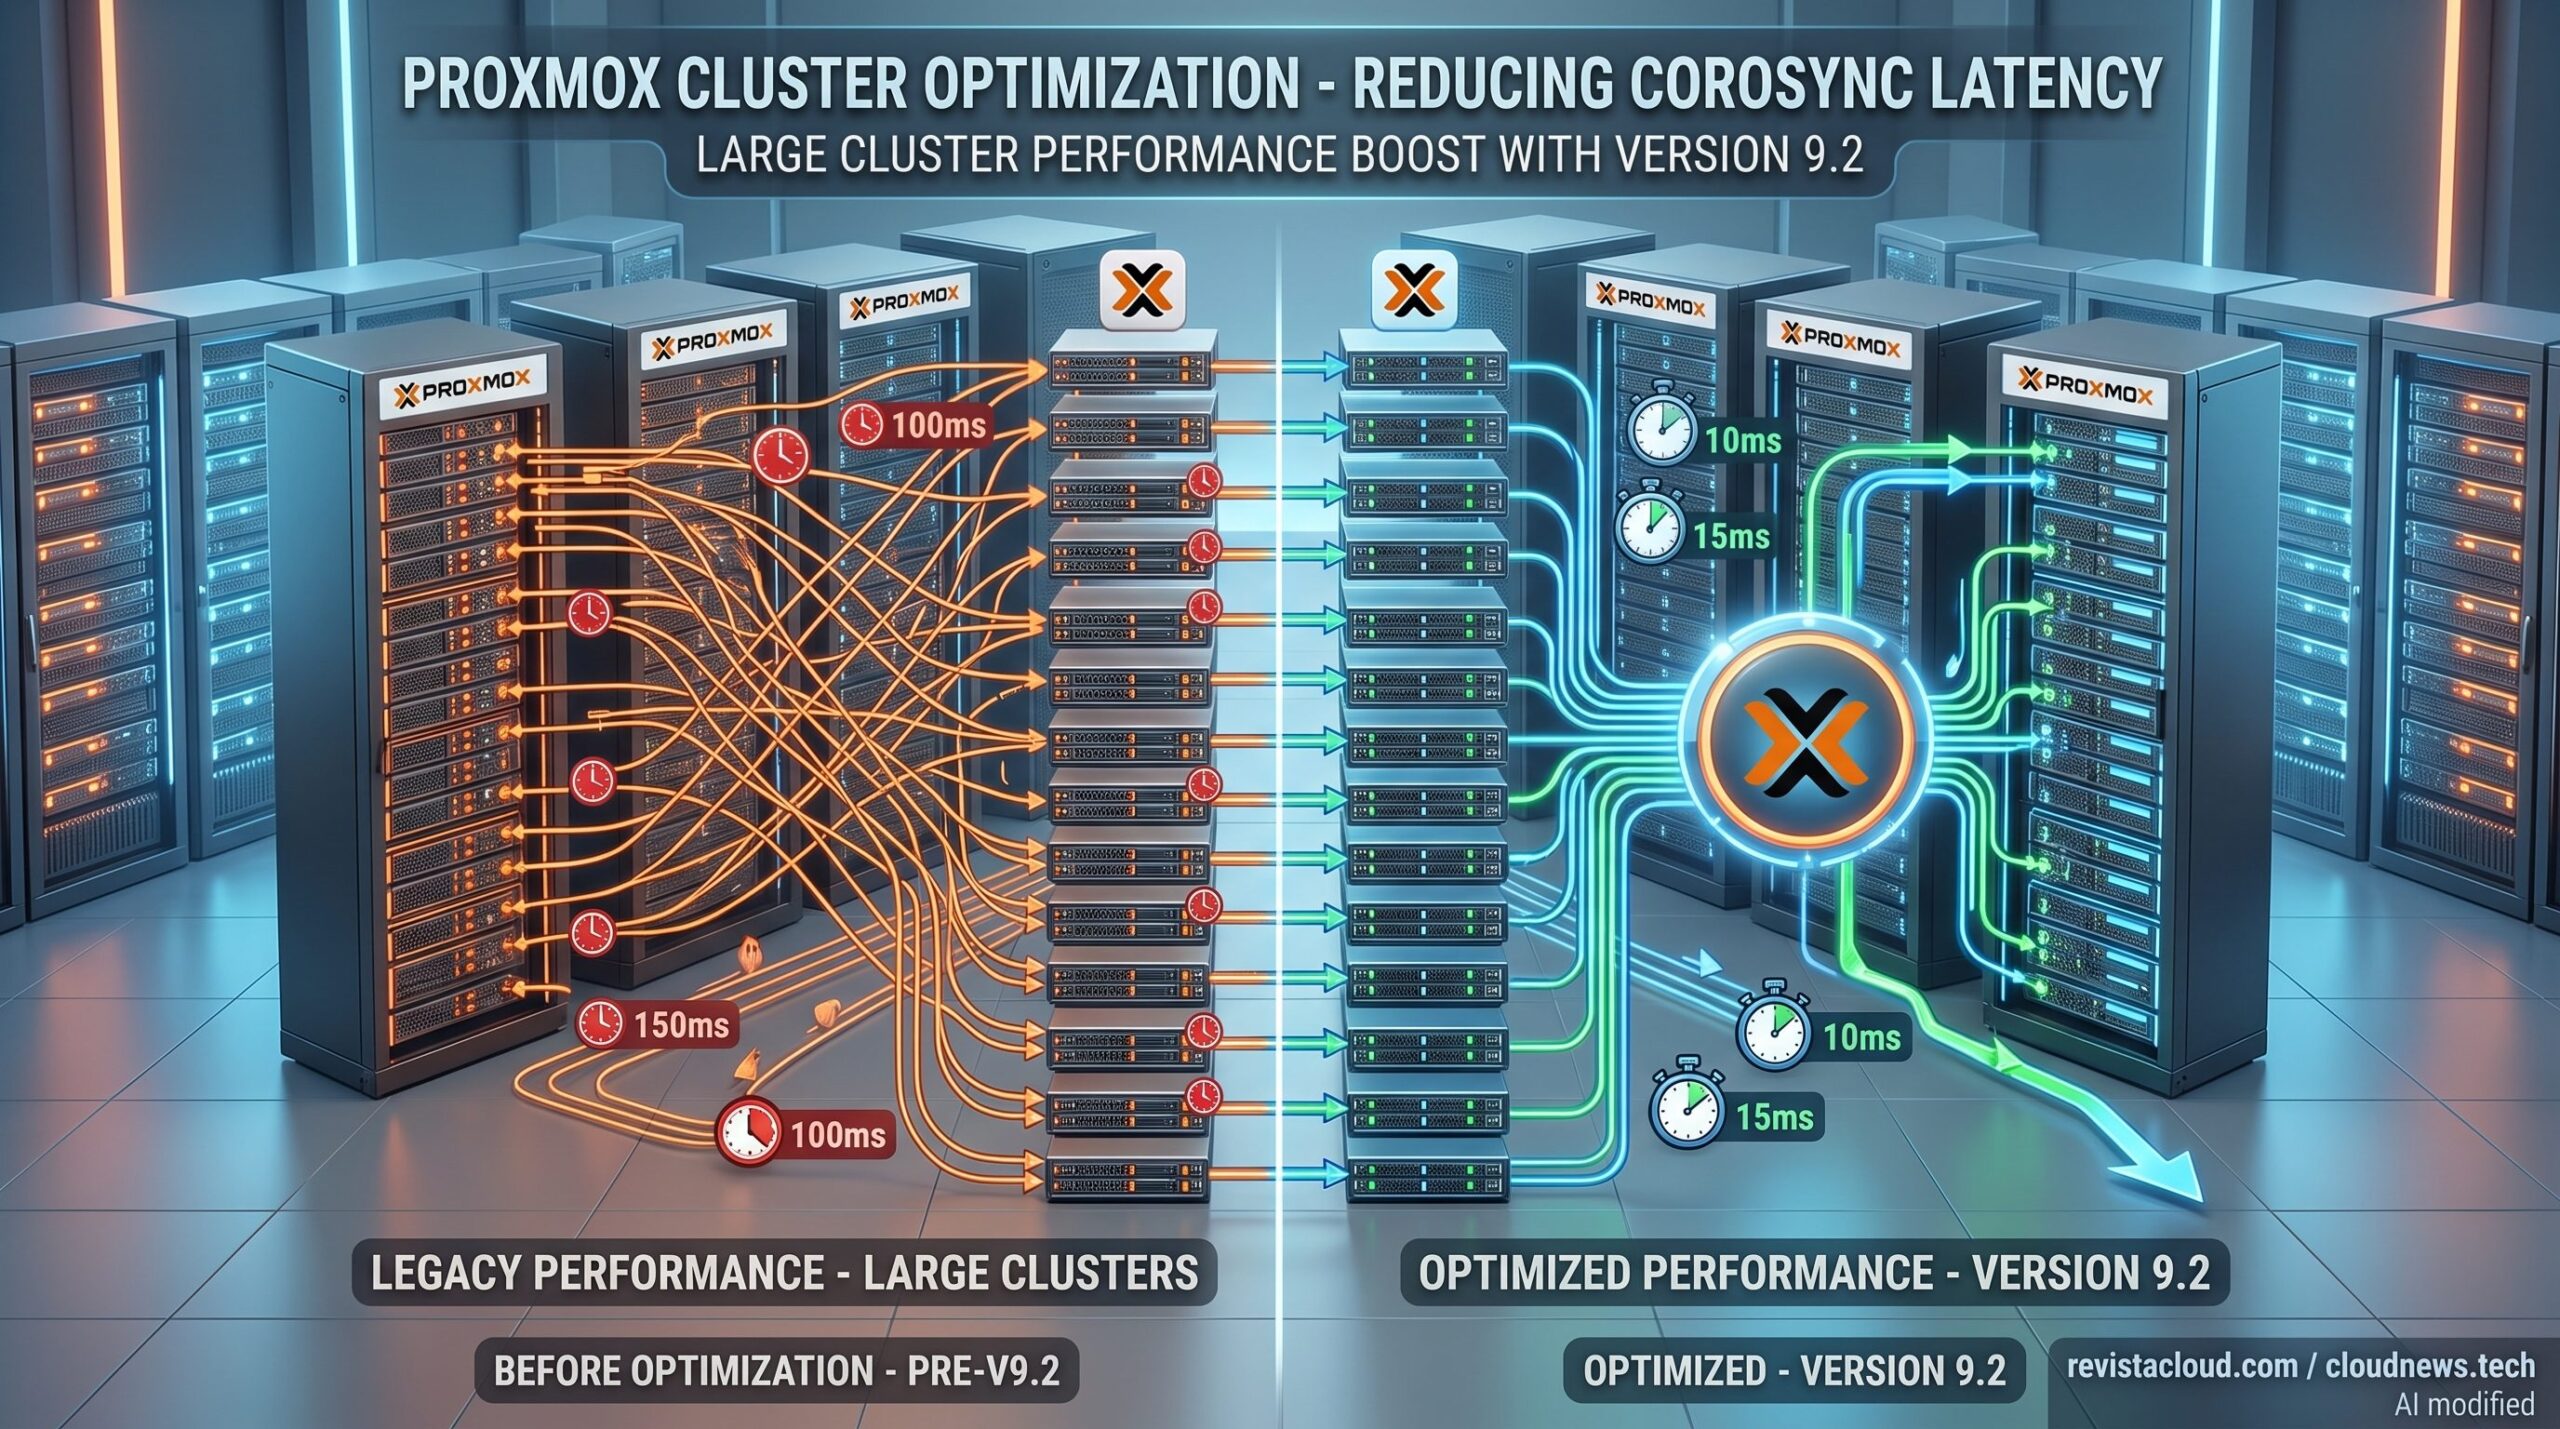
Un cluster Proxmox VE de 47 nodos que conserve los temporizadores históricos de Corosync puede alcanzar aproximadamente 70,95 segundos entre token y consensus antes de completar una nueva membresía tras perder un nodo. La cifra no representa el tiempo total de recuperación de las máquinas virtuales, pero sí revela un problema importante: supera el watchdog de 60 segundos utilizado por Proxmox HA para el self-fencing, por lo que una infraestructura de este tamaño merece revisar su configuración antes de asumir que los valores heredados siguen siendo adecuados.
Las claves de Corosync en un cluster Proxmox de 47 nodos en 20 segundos
- Con
tokenbase de 3.000 ms y coeficiente de 650 ms, 47 nodos llevan eltokenefectivo a 32,25 segundos. - El
consensusautomático asciende a unos 38,70 segundos. - La suma alcanza aproximadamente 70,95 segundos.
- Con el coeficiente de 125 ms usado en nuevos clusters Proxmox VE 9.2, baja a unos 18,98 segundos.
- Al superar 32 nodos también conviene revisar otros parámetros y, sobre todo, la calidad de la red de Corosync.
La diferencia frente a un cluster de 10 o 15 servidores es considerable porque el tiempo efectivo de Corosync no permanece constante cuando se utiliza token_coefficient.
El objetivo de este mecanismo es razonable: conforme aumenta el número de miembros, Corosync introduce más margen para que el protocolo de membresía pueda trabajar sin que el administrador tenga que reajustar manualmente el token cada vez que añade un nodo.
El problema aparece cuando un cluster lleva años creciendo y mantiene una configuración heredada. Un valor que tenía poco efecto con cinco servidores puede convertirse en decenas de segundos adicionales cuando la infraestructura alcanza varias decenas de nodos.
De 3 segundos a 32,25 segundos de token efectivo
En las versiones de Corosync utilizadas tradicionalmente por Proxmox, el token parte de 3.000 milisegundos y el token_coefficient histórico es de 650 ms cuando no se especifica otro valor.
Con una lista de al menos tres nodos, el tiempo efectivo se obtiene mediante:
token efectivo = token + (nodos − 2) × token_coefficient
La fórmula está documentada por Corosync. Su objetivo es permitir que el tiempo aumente automáticamente a medida que crece el cluster.
Para 47 nodos:
3.000 + (47 − 2) × 650
Hay 45 nodos adicionales sobre los dos primeros:
45 × 650 = 29.250 ms
Por tanto:
3.000 + 29.250 = 32.250 ms
El token efectivo queda en 32,25 segundos.
Pero todavía falta consensus.
Cuando no se fija explícitamente, Corosync lo calcula como mínimo a 1,2 veces el token efectivo:
32.250 × 1,2 = 38.700 ms
Sumando ambos:
32.250 + 38.700 = 70.950 ms
El resultado es aproximadamente 70,95 segundos.
| Parámetro | 47 nodos, coeficiente 650 ms |
|---|---|
| Token base | 3.000 ms |
| Incremento por nodos | 29.250 ms |
| Token efectivo | 32.250 ms |
| Consensus aproximado | 38.700 ms |
| Token + consensus | 70,95 s |
Estos valores son temporizadores calculados, no una medición del tiempo que tardará realmente una aplicación en recuperarse.
La distinción es importante. Después de formar la nueva membresía todavía pueden intervenir Proxmox HA Manager, fencing, almacenamiento, disponibilidad de CPU y RAM, arranque de las máquinas virtuales y recuperación de sus servicios.
Pero 70,95 segundos llaman la atención por otro motivo.
Los 70,95 segundos ya chocan con el watchdog de Proxmox HA
Proxmox utiliza un watchdog como parte de su mecanismo de self-fencing.
Un nodo HA que pierde quorum deja de poder mantener correctamente ese watchdog y, si no recupera la situación, termina reiniciándose cuando expira el temporizador. Proxmox documenta un timeout de unos 60 segundos para este proceso.
La finalidad es evitar que un nodo aislado continúe ejecutando máquinas virtuales mientras otra parte del cluster considera que puede recuperarlas en otro lugar.
Por eso Proxmox insiste en que los tiempos relacionados con la formación de la nueva membresía deben mantener suficiente margen frente al watchdog.
Con 29 nodos y 650 ms, la suma calculada era de aproximadamente 45,21 segundos.
Con 47 nodos pasa a 70,95 segundos.
Es decir, ya no se trata simplemente de acercarse al margen de 60 segundos: la configuración teórica lo supera claramente.
Esto no permite afirmar que un cluster de 47 nodos vaya a reiniciar necesariamente servidores cada vez que pierde un miembro. El comportamiento real depende de qué nodos pierdan conectividad, la topología de red, el quorum, los mensajes que consiga intercambiar Corosync y otros temporizadores.
Sí permite afirmar algo mucho más útil: un cluster de 47 nodos no debería operar con estos valores sin haberlos revisado expresamente.
Con 125 ms el mismo cluster baja a unos 19 segundos
Proxmox ha reaccionado reduciendo considerablemente el coeficiente utilizado en clusters nuevos.
La documentación introducida para Proxmox VE 9.2 especifica un token_coefficient de 125 milisegundos en los nuevos clusters, en lugar de dejar que se aplique el comportamiento histórico de 650 ms.
La misma cuenta para 47 servidores cambia mucho:
3.000 + (47 − 2) × 125
45 × 125 = 5.625 ms
Por tanto:
3.000 + 5.625 = 8.625 ms
El consensus aproximado:
8.625 × 1,2 = 10.350 ms
Y la suma:
8.625 + 10.350 = 18.975 ms
Es decir, aproximadamente 18,98 segundos.
| Configuración | Token efectivo | Consensus | Total aproximado |
|---|---|---|---|
| 47 nodos, 650 ms | 32,25 s | 38,70 s | 70,95 s |
| 47 nodos, 125 ms | 8,63 s | 10,35 s | 18,98 s |
La reducción ronda los 52 segundos únicamente modificando el coeficiente utilizado para calcular los temporizadores.
En porcentaje, la suma de token + consensus cae aproximadamente un 73 %.
No significa que una VM vaya a recuperarse 52 segundos antes en cualquier incidencia, porque existen más etapas. Pero sí reduce de forma muy importante una parte del proceso de detección y reorganización del cluster.
Actualizar desde Proxmox 8 no implica necesariamente recibir el nuevo valor
Aquí aparece uno de los puntos que más deberían revisar los administradores.
El comportamiento nuevo se aplica al crear clusters nuevos con las versiones actuales de Proxmox VE. Una infraestructura existente conserva normalmente su corosync.conf, por lo que actualizar desde una versión anterior no equivale a reconstruir automáticamente sus parámetros de Corosync.
Eso significa que un cluster que haya crecido durante años podría ejecutar Proxmox VE 9 y seguir utilizando una configuración concebida cuando tenía muchos menos nodos.
La comprobación de los valores efectivos es sencilla:
corosync-cmapctl | grep -Ew 'runtime.config.totem.token|runtime.config.totem.consensus'El dato importante es consultar el valor de ejecución, no deducirlo simplemente por la versión instalada.
En un cluster de 47 nodos que siguiera utilizando el coeficiente histórico deberían aparecer valores próximos a:
runtime.config.totem.token = 32250
runtime.config.totem.consensus = 38700
Con un coeficiente de 125 ms serían aproximadamente:
runtime.config.totem.token = 8625
runtime.config.totem.consensus = 10350
Los valores exactos deben obtenerse siempre del propio cluster.
Además, cambiar token_coefficient directamente porque una tabla indique un número elevado no es una práctica aconsejable. Corosync advierte de que los temporizadores deben ser consistentes y estar adaptados al comportamiento real de la red.
Reducir los tiempos sobre una red con pérdida de paquetes, jitter o latencia irregular puede convertir una configuración conservadora en una fuente de falsas detecciones.
Con 47 nodos aparece otra advertencia de Corosync: ya son más de 32
Un cluster de 47 miembros añade además un detalle que apenas importa en instalaciones pequeñas.
La documentación de Corosync señala que para anillos con más de 32 nodos puede ser necesario prestar atención al parámetro send_join, utilizado durante la formación de nuevas membresías.
El manual explica que en clusters inferiores a 32 nodos normalmente no es necesario, mientras que en anillos mayores puede ser relevante para evitar que la interfaz de red reciba una avalancha de mensajes join cuando se forma un nuevo anillo. También advierte de que los demás temporizadores deben coordinarse con cualquier cambio y recomienda recurrir a asesoramiento especializado para configuraciones grandes.
Eso convierte el ejemplo de 47 nodos en algo más que una simple extrapolación matemática.
A este tamaño ya merece la pena tratar Corosync como una infraestructura propia dentro del cluster y no como una red de gestión secundaria a la que se asigna el ancho de banda que sobra.
Proxmox tampoco establece un límite duro pequeño de nodos. Su documentación señala que no existe un máximo explícito y recoge despliegues de más de 50 nodos, aunque advierte de que el límite práctico depende del rendimiento de los hosts y, especialmente, de la red.
En clusters grandes la red importa más que bajar un número
Corosync no necesita grandes cantidades de ancho de banda en condiciones normales, pero sí requiere latencia baja, estabilidad y ausencia de pérdida de paquetes.
En un cluster de 47 servidores aumenta además el número de relaciones y eventos que deben procesarse cuando cambia la membresía.
Por eso una revisión debería incluir, como mínimo, latencia entre nodos, pérdida de paquetes, redundancia de enlaces, switching, MTU, saturación, aislamiento de tráfico y funcionamiento de Kronosnet.
Si existe HA, también conviene probar qué sucede realmente cuando un nodo desaparece.
No basta con medir cuándo la interfaz de Proxmox muestra el servidor como desconectado. El dato útil es cuánto tarda el servicio que estaba ejecutándose en ese nodo en volver a responder desde otro host.
El cronómetro real incluye:
detección Corosync → nueva membresía → fencing → HA Manager → acceso al almacenamiento → arranque de la VM → arranque de la aplicación
Cada arquitectura producirá un tiempo diferente.
También importa la capacidad disponible. Un cluster de 47 nodos puede tener unos temporizadores impecables y fallar igualmente en su objetivo de alta disponibilidad si los otros 46 hosts no tienen CPU o RAM para asumir las máquinas afectadas.
Lo mismo ocurre con el almacenamiento. Si las VMs dependen de una plataforma compartida o distribuida degradada por la misma incidencia, acelerar Corosync no garantiza una recuperación rápida.
Por eso la revisión del token resulta valiosa como indicador, pero no debería confundirse con una optimización completa de HA.
En una infraestructura de 47 nodos, encontrar aproximadamente 70,95 segundos en token + consensus sería una señal clara para revisar el diseño. Encontrar 18,98 segundos tampoco demuestra por sí mismo que todo esté bien: simplemente indica que esa parte concreta dispone de mucho más margen respecto al watchdog.
Preguntas frecuentes
¿Cuánto tardaría Corosync con 47 nodos y un coeficiente de 650 ms?
Con token base de 3.000 ms, el token efectivo sería de unos 32,25 segundos y el consensus de 38,70 segundos. Su suma es aproximadamente 70,95 segundos.
¿Qué tiempo resulta con token_coefficient de 125 ms?
En el mismo cluster de 47 nodos el token efectivo baja a unos 8,63 segundos y el consensus a 10,35 segundos, para un total aproximado de 18,98 segundos.
¿Actualizar a Proxmox VE 9 cambia automáticamente este parámetro?
No debería darse por hecho. El valor de 125 ms se establece para clusters nuevos según la documentación actual, mientras que una instalación actualizada puede conservar su configuración anterior. Lo recomendable es consultar los parámetros efectivos con corosync-cmapctl.
¿Se puede cambiar directamente el coeficiente de 650 a 125 ms?
No debería hacerse sin comprobar antes la red, la configuración actual y el comportamiento del cluster. Los temporizadores de Corosync afectan a la detección de fallos y una reducción excesiva en una red inestable puede provocar problemas adicionales.
Fuentes:
- Proxmox VE, Cluster Manager, documentación oficial sobre Corosync, tamaño de cluster y quorum.
- Corosync,
corosync.conf(5), documentación detoken,token_coefficient,consensusysend_join. - Proxmox VE, documentación técnica de High Availability y mecanismos de fencing.