La amenaza para el negocio de OpenAI y Anthropic podría no estar en sus cuentas, sino en una tarjeta gráfica de 24 GB capaz de ejecutar en local modelos de IA suficientemente buenos: esa es la tesis, tan provocadora como discutible, que ha publicado la revista Jot Down. El artículo, firmado por Ángel L. Fernández Recuero el 26/09/2026, sostiene que lo que puede romperse en los próximos años es la lógica de pagar por cada token cuando buena parte del trabajo diario de una empresa cabe en un equipo propio.
Las claves de la tesis de la IA local frente a OpenAI y Anthropic en 20 segundos
- Jot Down defiende que un PC con 24 GB de VRAM ya cubre muchas tareas empresariales.
- Su autor estima que entre el 20 % y el 40 % de la inferencia generalista podría pasar a local antes de 2030.
- OpenAI prevé quemar 278.000 millones de dólares entre 2026 y 2030, según el FT.
- Anthropic, en cambio, dice a sus inversores que encadenará dos trimestres con beneficio operativo ajustado.
El texto no anuncia literalmente la quiebra de nadie, a pesar del titular. Su autor admite que ambas compañías pueden sobrevivir y matiza que «no desaparecerá la nube». Lo que plantea es otra cosa: que, para una parte creciente de los usos, el modelo de suscripción y API puede dejar de ser la opción más racional económicamente frente a un equipo comprado una vez.
Lo que sostiene Jot Down
El argumento parte de una experiencia personal. Fernández Recuero empezó a usar modelos locales por la cautela excesiva y los filtros que detecta en los grandes modelos estadounidenses y chinos, y descubrió que modelos que no están en la vanguardia resuelven bien tareas de oficina: clasificar documentos, resumir expedientes, buscar en bases de datos internas, redactar correos e informes, revisar código o automatizar procesos rutinarios. Para eso, escribe, no hace falta un centro de datos, sino una GPU de consumo con 24 GB de memoria y modelos comprimidos mediante cuantización, con formatos como Q4_K_M o IQ3_XS.
La pieza también se apoya en el hardware. Recuerda que equipos como los basados en el AMD Ryzen AI Max+ 395 admiten hasta 128 GB de memoria compartida y que los chips de Apple reparten la misma memoria física entre CPU y GPU, dos vías para mover modelos más grandes sin una tarjeta dedicada. Su ejemplo de coste es una pequeña empresa que compra en 2029 un equipo de IA de 800 euros y lo amortiza en tres años: unos 22 euros al mes de hardware y entre 30 y 40 euros con electricidad, almacenamiento y mantenimiento. Lo resume con una imagen: un ordenador «debajo de la mesa que, después de comprado, no vuelve a pasar una factura».
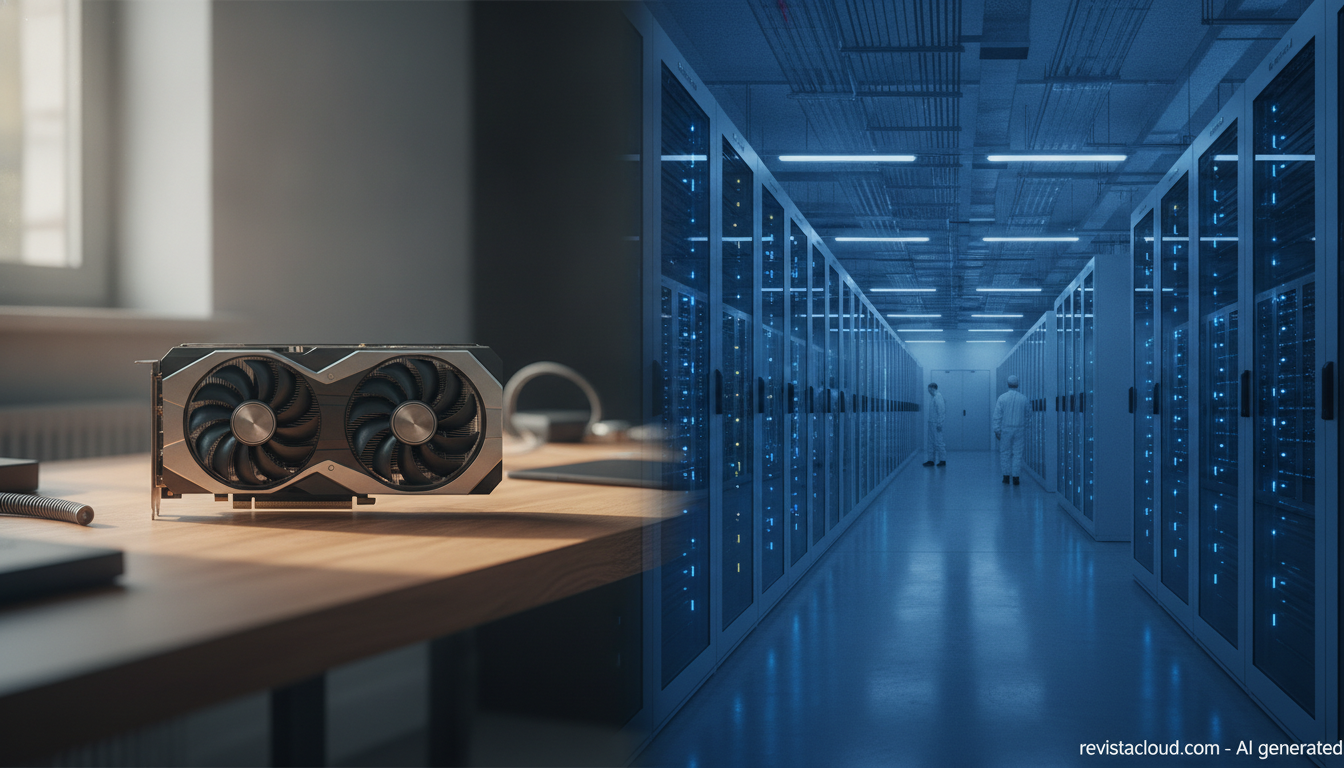
Conviene leer esas cifras como lo que son. El porcentaje de migración del 20 % al 40 % es una estimación del propio autor, no un estudio publicado, y el escenario de 800 euros depende de que los precios de la memoria y las GPU vuelvan a una curva normal. Hoy ocurre lo contrario: el artículo sitúa la tarjeta de la foto, una RTX 5090 de 32 GB, en torno a 3.500 euros, por la presión de la demanda de IA.
Las cuentas reales de OpenAI y Anthropic
La parte financiera sí tiene base documental, aunque sea a través de filtraciones. Según una presentación interna de OpenAI publicada por el Financial Times y recogida por Reuters el 18/09/2026, la compañía prevé un flujo de caja libre negativo de 278.000 millones de dólares entre 2026 y 2030 y un gasto en computación e infraestructura de unos 856.000 millones hasta final de la década. En paralelo, espera multiplicar por diez sus ingresos, de 36.000 millones en 2026 a 350.000 millones en 2030. Los 122.000 millones que captó en marzo, con una valoración de 852.000 millones, se agotarían hacia 2028.
OpenAI también ha abierto la vía publicitaria. Empezó a probar anuncios en ChatGPT en febrero y a finales de agosto aseguró haber superado los 1.000 millones de dólares de ingresos anualizados en publicidad, con un objetivo de 2.500 millones a final de año, según SiliconANGLE. Anthropic sigue otro camino: como recuerda Jot Down, mantiene que Claude no tendrá anuncios y se financia con empresas, desarrolladores y suscripciones. Según el Financial Times, ha comunicado a sus accionistas que su beneficio operativo ajustado será positivo por segundo trimestre consecutivo, con márgenes brutos superiores al 80 %, una cifra que excluye los ingresos compartidos con socios como Amazon y el coste de entrenar sus modelos. Reuters no pudo verificar esos datos de forma independiente.
La paradoja que señala Jot Down es real en su planteamiento: estas empresas invierten cientos de miles de millones en infraestructura centralizada para vender inferencia, mientras una parte de esa inferencia empieza a ser viable en equipos propios. Pero las dos compañías no están en la misma situación, y meterlas en el mismo saco debilita el argumento.
Dónde acierta la tesis y dónde se queda corta
La lectura de Revista Cloud es que la tesis acierta en la dirección y exagera la velocidad. Ejecutar en local un modelo de 27.000 o 30.000 millones de parámetros cuantizado a 4 bits ocupa en torno a 15-18 GB, lo que deja margen en una tarjeta de 24 GB para el contexto de trabajo. Para tareas acotadas y repetitivas, sobre datos que la empresa no quiere sacar de casa, el ahorro puede ser enorme: Noticias.ai ya contó el caso de una empresa que bajó de 5.600 a 13 euros su factura de traducción con IA local. La soberanía del dato también juega a favor: con el RGPD y el Reglamento Europeo de IA, no enviar información sensible a un tercero simplifica mucho el cumplimiento.
La otra cara es menos vistosa. Un equipo bajo la mesa no ofrece alta disponibilidad, no escala con decenas de usuarios simultáneos y necesita alguien que actualice modelos, controle accesos y vigile la seguridad. Los modelos de vanguardia siguen siendo muy superiores en razonamiento largo, programación compleja y agentes, y muchas empresas pagarán por esa diferencia. Lo más probable es un mercado híbrido, con tareas rutinarias en local o en nube privada y llamadas puntuales a los grandes modelos cuando hacen falta. En ese terreno intermedio ya se mueven propuestas como VMware Private AI Cloud, que une nube privada, agentes e inferencia, pensadas para empresas que quieren modelos propios sin montar un equipo bajo cada mesa.
La conclusión práctica para una empresa es menos dramática que el titular de Jot Down, pero útil: medir qué parte de su consumo de API corresponde a tareas que un modelo abierto resuelve igual de bien, y estudiar si esa parte cabe en hardware propio. Revista Cloud ya explicó por qué la IA local necesita más memoria y cómo cambia el hardware para ejecutar modelos en el PC, y Noticias.ai ha analizado este mismo debate en IA local en 24 GB frente a OpenAI y Anthropic: qué hay de cierto en la tesis.
Preguntas frecuentes
¿Qué defiende el artículo de Jot Down?
Que la inferencia local en tarjetas de 24 GB puede restar a OpenAI y Anthropic entre un 20 % y un 40 % del gasto en IA generalista antes de 2030, una estimación del propio autor.
¿Cuánto dinero prevé perder OpenAI?
Según una presentación interna publicada por el Financial Times, OpenAI prevé un flujo de caja libre negativo de 278.000 millones de dólares entre 2026 y 2030.
¿Es rentable Anthropic?
Según el Financial Times, Anthropic ha dicho a sus accionistas que su beneficio operativo ajustado será positivo por segundo trimestre consecutivo, aunque Reuters no pudo verificarlo.
¿Qué modelos caben en una GPU de 24 GB?
Modelos de unos 27.000 a 30.000 millones de parámetros cuantizados a 4 bits, que ocupan en torno a 15-18 GB y dejan margen para el contexto.
Fuentes:
- Jot Down: La quiebra de OpenAI y Anthropic cabe en menos de 24GB
- Reuters vía The Star: OpenAI forecasts cash burn near $280 billion by 2030, FT reports
- Reuters vía The Star: Anthropic tells investors it will be profitable for second straight quarter
- SiliconANGLE: OpenAI says its ad business has already hit $1B in annualized revenue
- Noticias.ai: IA local en 24 GB frente a OpenAI y Anthropic: qué hay de cierto en la tesis