Las TPU de Google se han hecho un sitio en la inferencia de modelos de lenguaje por su coste por token más que por su velocidad de respuesta, y la séptima generación, Ironwood (TPU7x), multiplica por 4,5 el ancho de banda de memoria de su predecesora, Trillium (TPU v6e). Sobre ese dato construye Sonnet Xu (@sonnet_xu) un análisis publicado en X el 04/11/2026, en el que plantea que el salto podría permitir a Google competir también en latencia, un terreno en el que NVIDIA ha dominado las cargas interactivas.
Las claves de las TPU de Google en inferencia en 30 segundos
- Según el análisis de Sonnet Xu en X, la ventaja histórica de las TPU ha sido el rendimiento con peticiones agrupadas en lotes, no la latencia.
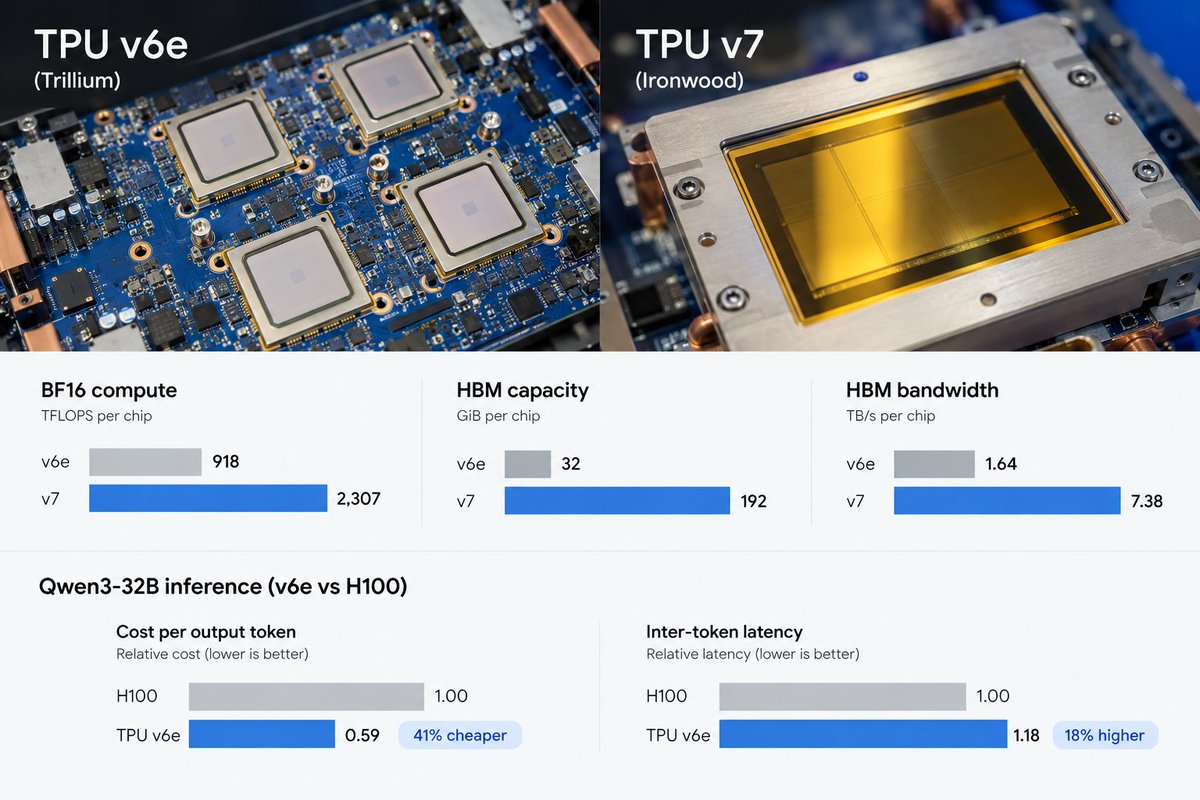
- En un benchmark con Qwen3-32B cuyo origen no detalla, la TPU v6e salió un 41 % más barata por token de salida que la H100 de NVIDIA, con un 18 % más de latencia entre tokens.
- La documentación de Google confirma 7,38 TB/s de ancho de banda de memoria por chip en TPU7x, frente a 1,64 TB/s en v6e.
- Google refuerza a la vez el software de inferencia para TPU con vLLM y SGLang.
Una TPU (unidad de procesamiento tensorial) es el acelerador que Google diseña para sus propios modelos y que alquila en Google Cloud. A diferencia de una GPU de propósito más general, su núcleo de cálculo se organiza en grandes matrices sistólicas, bloques de multiplicadores por los que los datos fluyen de forma rítmica y que rinden al máximo con multiplicaciones de matrices densas. Xu sostiene que esa arquitectura favorece el procesamiento por lotes y la inferencia asíncrona, en la que importa más cuántos tokens se generan por euro que cuánto tarda en llegar cada uno.
Un 41 % más barata, pero un 18 % más lenta entre tokens
El dato central del análisis procede de una comparativa con Qwen3-32B, un modelo abierto de Alibaba con 32.000 millones de parámetros. En ella, la TPU v6e obtuvo un coste relativo por token de salida de 0,59 frente al 1,00 de la H100, es decir, un 41 % menos. La latencia entre tokens, el tiempo que pasa entre una palabra generada y la siguiente, fue de 1,18 frente a 1,00: un 18 % peor. La publicación de Xu no enlaza el estudio original y Revista Cloud no ha podido localizarlo en el blog de Google Cloud, en el de vLLM ni en la documentación de SGLang, así que la cifra debe leerse como parte de su análisis y no como un resultado verificado de forma independiente.
El patrón encaja con otros datos publicados, aunque con matices. Un trabajo publicado en arXiv en junio de 2026 sobre Gemma 4 31B, servido con vLLM en una TPU v6e-8 frente a dos H100 de 80 GB, también calculó un coste por token de salida un 41 % menor en la TPU, pero solo con contextos largos, de 4.096 tokens o más. Con contextos cortos, de hasta 2.048 tokens, la GPU resultó un 3 % más barata, y con entradas de 128 tokens la latencia entre tokens del percentil 99 fue algo mayor en la TPU (22,29 frente a 20,49 milisegundos). Es otro modelo y otra configuración, pero muestra que la comparación depende mucho del tipo de carga.
La explicación técnica tiene que ver con la memoria. En la fase de decodificación, cuando el modelo genera texto token a token, cada paso obliga a leer los pesos y la caché de atención desde la HBM (memoria de alto ancho de banda). Con lotes pequeños, que son los habituales en un chat o en un agente que responde en tiempo real, el cálculo espera a la memoria. Por eso el ancho de banda pesa más en la latencia que la potencia bruta.
Lo que dicen las especificaciones oficiales de Ironwood y Trillium
Las cifras de la imagen que acompaña la publicación coinciden en lo esencial con la documentación de Google Cloud, con algunos redondeos y una diferencia de unidades. La tabla recoge los valores por chip de las páginas oficiales de TPU v6e y TPU7x.
| Especificación por chip | TPU v6e (Trillium) | TPU7x (Ironwood) |
|---|---|---|
| Cómputo máximo BF16 | 918 TFLOPS | 2.307 TFLOPS |
| Cómputo máximo de 8 bits | 1.836 TOPS (INT8) | 4.614 TFLOPS (FP8) |
| Capacidad HBM | 32 GB (unos 31,25 GiB utilizables) | 192 GiB |
| Ancho de banda HBM | 1.638 GB/s | 7.380 GB/s |
| Interconexión entre chips (ICI, bidireccional) | 800 GB/s | 1.200 GB/s |
| Chips por pod | 256 | 9.216 |
Los TFLOPS miden billones de operaciones de coma flotante por segundo. BF16 (bfloat16) es un formato de 16 bits muy usado en IA, y FP8 es uno de 8 bits que permite duplicar el rendimiento teórico. Cuando Google presentó Ironwood en abril de 2025 anunció 4.614 TFLOPS por chip, una cifra que corresponde a FP8; el valor BF16 de 2.307 TFLOPS que figura en la documentación y en la imagen es exactamente la mitad.
El «4,5 veces» también cuadra: 7.380 entre 1.638 da 4,5, y Google usó ese mismo múltiplo frente a Trillium en su presentación, donde habló de 7,37 TB/s. La capacidad de memoria sube seis veces. La única discrepancia está en las unidades: la imagen expresa la memoria de v6e en GiB, pero la página oficial habla de 32 GB y aclara que las herramientas reportan unos 31,25 GiB utilizables. En Ironwood ocurre lo contrario: el anuncio de 2025 decía 192 GB y la documentación actual usa 192 GiB.
El salto también se nota en el precio. La tarifa pública de Google Cloud consultada para este artículo fija Trillium en 2,70 dólares por chip y hora bajo demanda en us-east5 (Ohio) e Ironwood en 12,00 dólares en us-central1 (Iowa), con descuentos por compromiso a uno y tres años. En noviembre de 2025, al anunciar la disponibilidad general, Google afirmó que Ironwood ofrece más de cuatro veces el rendimiento por chip de Trillium en entrenamiento e inferencia. El coste por token dependerá de cuánto de esa mejora se traslade a cada modelo concreto.
vLLM, SGLang y clientes: el software decide la latencia
El hardware es solo una parte. En octubre de 2025, un equipo de Google presentó en el blog de vLLM el nuevo backend tpu-inference, que unifica JAX y PyTorch bajo una misma ruta de compilación hacia XLA. Según ese anuncio, el rendimiento mejoró 3,6 veces con Llama 3.1-8B en una v6e-1 y 2,1 veces con Llama 3.1-70B en una v6e-8 respecto a su trabajo anterior de 2025. SGLang, el otro gran motor de servicio abierto, mantiene dos backends para TPU: SGL-JAX, compatible con v6e y v7, y SGLang-TorchTPU, centrado en TPU7x. A eso se suma la apuesta de Google por ejecutar PyTorch de forma nativa en sus TPU con TorchTPU.
La demanda externa también ha crecido. Google y Anthropic anunciaron en octubre de 2025 que la empresa de Claude prevé acceder a hasta un millón de TPU de Google Cloud, y en el anuncio de disponibilidad general de Ironwood su responsable de cómputo, James Bradbury, destacó las mejoras del chip tanto en rendimiento de inferencia como en escalabilidad del entrenamiento. Revista Cloud ya ha analizado cómo las TPU de Google desafían a NVIDIA en rendimiento por dólar.
Xu concluye que la próxima ola de demanda de inferencia será interactiva y basada en agentes, y que si las TPU logran competir en latencia, además de en coste, podrían pasar del procesamiento por lotes barato a las cargas más caras, históricamente en manos de NVIDIA. Es una hipótesis razonable a la vista del ancho de banda de Ironwood, pero por ahora no hay una comparativa pública y verificable de latencia entre tokens de Ironwood frente a las GPU actuales de NVIDIA con el mismo modelo y el mismo motor.
Preguntas frecuentes
¿Cuánto ancho de banda de memoria tiene Ironwood frente a Trillium?
Según la documentación de Google Cloud, TPU7x (Ironwood) alcanza 7.380 GB/s por chip y TPU v6e (Trillium) 1.638 GB/s, unas 4,5 veces menos. La capacidad HBM pasa de 32 GB a 192 GiB.
¿Es la TPU v6e más barata que la H100 para inferencia?
En el benchmark con Qwen3-32B que cita Sonnet Xu, la v6e salió un 41 % más barata por token de salida, aunque con un 18 % más de latencia entre tokens. El origen de esa prueba no está identificado, y otro estudio con Gemma 4 31B solo encontró esa ventaja con contextos largos.
¿Ironwood iguala ya a NVIDIA en latencia?
No hay datos públicos verificables que lo demuestren. El mayor ancho de banda de memoria debería ayudar en la decodificación, pero falta una comparativa con el mismo modelo, motor y configuración.
¿Cuánto cuesta alquilar una TPU Ironwood en Google Cloud?
La tarifa pública marca 12,00 dólares por chip y hora bajo demanda en us-central1, frente a 2,70 dólares de Trillium en us-east5. Hay descuentos por compromiso de uno y tres años.
Fuentes:
- Sonnet Xu (@sonnet_xu) en X, 04/11/2026
- Google Cloud: TPU7x (Ironwood)
- Google Cloud: TPU v6e
- Google: Ironwood, the first Google TPU for the age of inference (09/04/2025)
- Google Cloud Blog: Ironwood TPUs and new Axion-based VMs (06/11/2025)
- Google Cloud: Cloud TPU pricing
- vLLM: vLLM TPU, a new unified backend supporting PyTorch and JAX on TPU (16/10/2025)
- SGLang: documentación para TPU
- arXiv: Fine-Tuning and Serving Gemma 4 31B on Google Cloud TPU (junio de 2026)