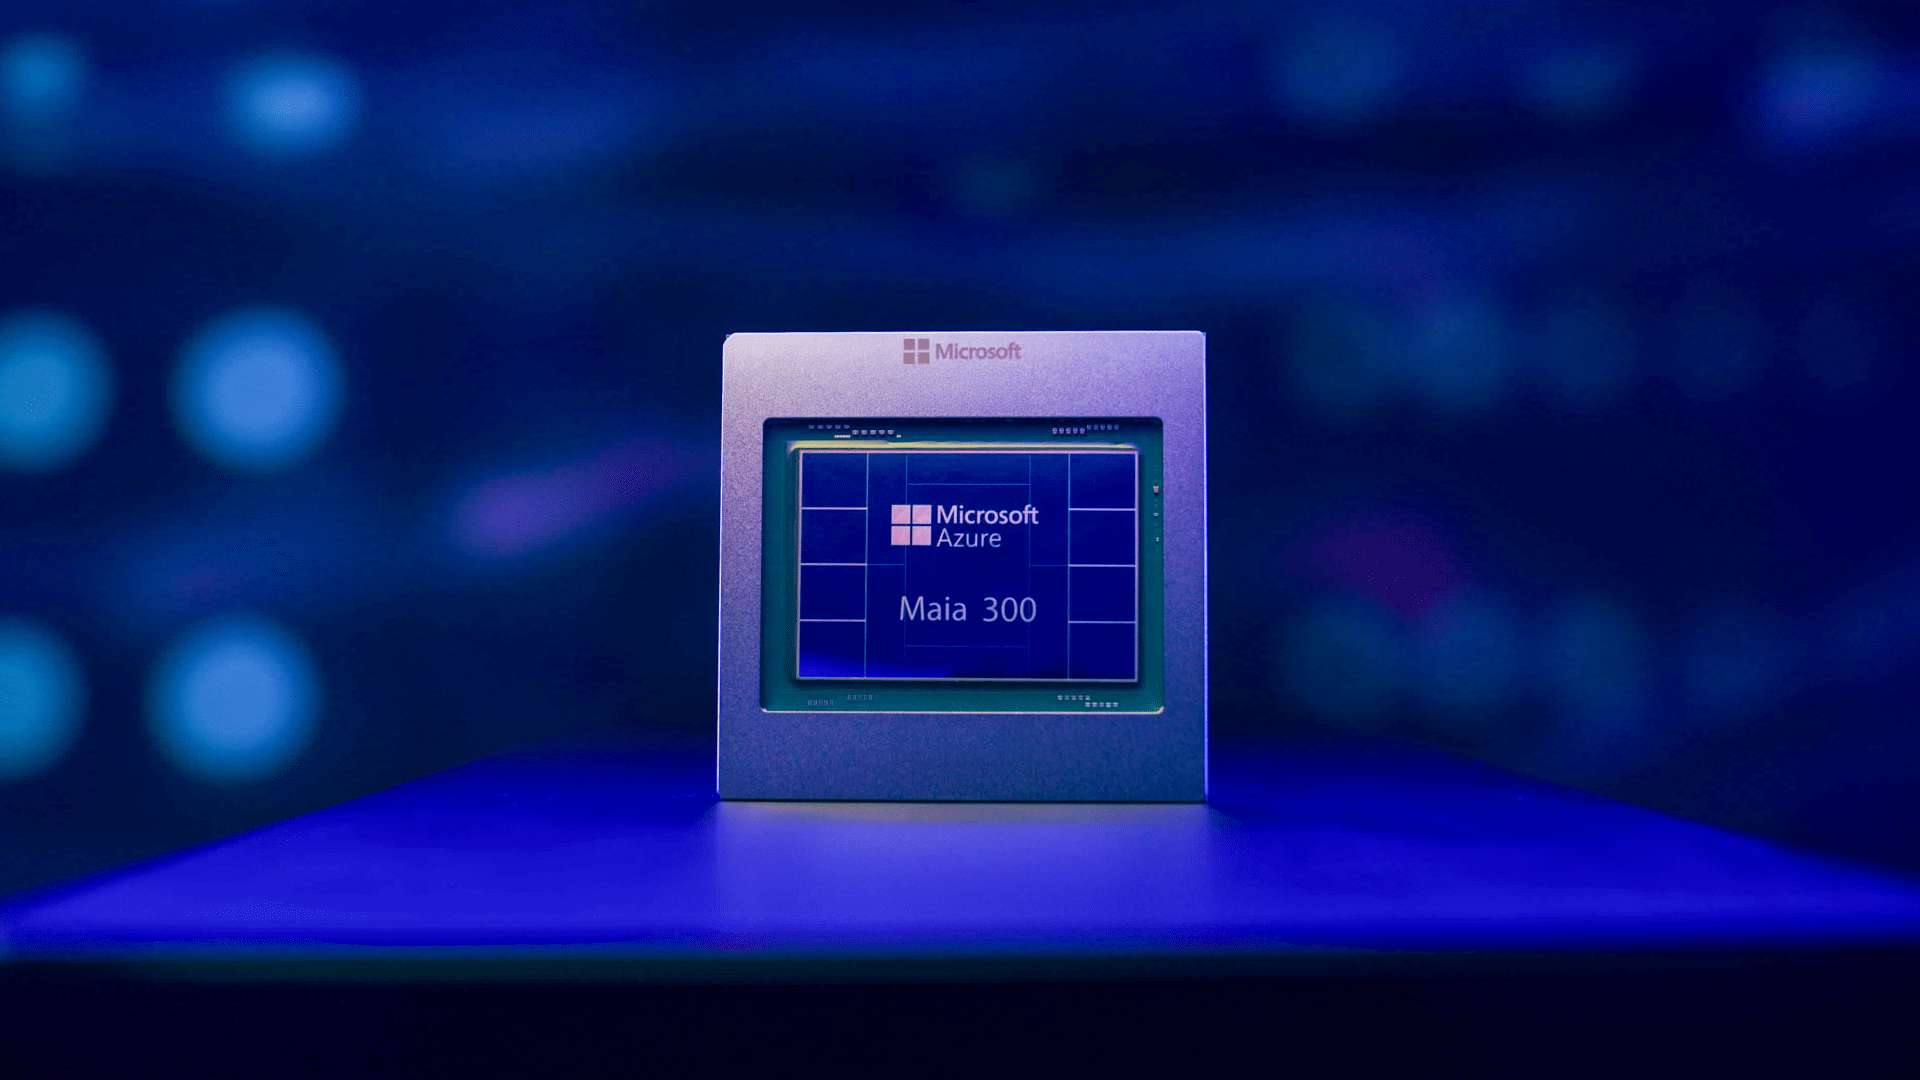
Microsoft ampliará su familia de aceleradores de inteligencia artificial (IA) Azure Maia hasta alcanzar despliegues de varios gigavatios a partir de 2027, con Maia 300 como siguiente generación de su infraestructura para ejecutar modelos. El nuevo chip utiliza una arquitectura de múltiples chiplets, integra memoria HBM4 de alto ancho de banda y emplea el proceso N2P de TSMC en sus chiplets de cálculo. La compañía busca aumentar la capacidad de inferencia y reducir el consumo energético necesario para atender sus servicios de IA.
Las claves de Maia 300 en 20 segundos
- Microsoft prevé iniciar los despliegues de Maia 300 en producción durante 2027 y ampliar la infraestructura Maia a varios gigavatios.
- Cada acelerador incorpora ocho pilas de memoria HBM4, con 288 GB de capacidad y 18 TB/s de ancho de banda máximo.
- Cada rack reúne 96 aceleradores, con una capacidad conjunta de 27,6 TB de HBM y un consumo previsto de hasta 167 kW.
- Microsoft afirma que Maia 300 puede generar un 40 % más de tokens por megavatio que sistemas basados en GPU de referencia.
- Maia 200 ya funciona con cargas de producción, incluidas las de Microsoft Copilot.
La presentación refleja un cambio en la infraestructura de Microsoft: la compañía quiere depender cada vez más de aceleradores diseñados para sus propias cargas de trabajo, en lugar de recurrir exclusivamente a procesadores gráficos de propósito general. El objetivo es atender modelos de lenguaje, asistentes de programación y sistemas de agentes que requieren grandes cantidades de memoria y capacidad de cálculo durante periodos prolongados.
Las cifras de rendimiento publicadas proceden de Microsoft y deben interpretarse como resultados declarados por el fabricante. La compañía no identifica en su anuncio todos los sistemas utilizados como referencia ni detalla una metodología independiente que permita comparar los resultados en condiciones idénticas.
Maia 300 combina chiplets de TSMC N2P y memoria HBM4
Maia 300 es la tercera generación del programa de aceleradores propios de Microsoft. Su diseño prioriza la inferencia, es decir, la ejecución de modelos ya entrenados para generar respuestas, procesar instrucciones o completar tareas. Esta actividad exige equilibrar la potencia de cálculo con la velocidad a la que los datos llegan a los procesadores.
Uno de los elementos principales es la memoria de alto ancho de banda HBM4. Cada acelerador incorpora ocho pilas que proporcionan 288 GB de capacidad y hasta 18 TB/s de ancho de banda máximo, según las especificaciones publicadas por Microsoft. El dispositivo tiene un consumo térmico de diseño de 950 vatios.
La memoria adquiere especial importancia cuando los modelos trabajan con contextos extensos, mantienen conversaciones largas o ejecutan tareas con varios pasos. En esos escenarios, mover datos entre la memoria y las unidades de cálculo puede limitar el rendimiento incluso cuando el procesador dispone de capacidad suficiente.
Microsoft también apuesta por una arquitectura de chiplets que separa las funciones de cálculo, los controladores de memoria y las entradas y salidas en distintos bloques. Esta organización permite diseñar cada parte según sus necesidades específicas de rendimiento, conectividad y coste.
Los chiplets de cálculo utilizan el proceso N2P de TSMC, una tecnología de fabricación avanzada de la compañía taiwanesa. Microsoft no ha publicado en el anuncio todos los detalles físicos del silicio ni los datos necesarios para establecer una comparación completa con otros aceleradores comerciales.
El diseño incorpora, además, formatos numéricos de baja precisión, entre ellos MXFP4 mejorado, con los que busca reducir los requisitos de memoria y ancho de banda. También utiliza la memoria SRAM integrada en el chip como espacio de trabajo gestionado por el software, una técnica que puede limitar los accesos a la memoria externa en determinadas operaciones.
La arquitectura se completa con una estructura de comunicaciones optimizada para conectar aceleradores dentro de un rack y entre distintos racks. Microsoft plantea que el movimiento de datos entre cálculo, memoria y red forme parte de un mismo sistema de ejecución, en lugar de tratar las comunicaciones como una capa independiente.
Racks de 167 kW para atender más solicitudes de IA
La configuración de referencia de Maia 300 agrupa 96 aceleradores en un rack con un límite de potencia de 167 kilovatios. En conjunto, dispone de 27,6 TB de memoria HBM y alcanza un ancho de banda agregado de 1,7 petabytes por segundo.
Estas cifras describen la capacidad conjunta del sistema, no la de un único chip. La memoria y el ancho de banda se distribuyen entre los aceleradores y dependen de la arquitectura de interconexión y de la forma en que se ejecutan las cargas de trabajo.
La potencia también da una idea de los requisitos físicos de la infraestructura. Un rack de estas características necesita una planificación eléctrica y térmica acorde con su consumo, además de una red capaz de comunicar los aceleradores con suficiente rapidez. Microsoft explica que su arquitectura incorpora refrigeración líquida para evacuar más del 80 % de la carga térmica de los aceleradores, los reguladores de voltaje y los circuitos de conmutación. La memoria, el almacenamiento y otros componentes auxiliares recurren a refrigeración por aire.
La conectividad combina enlaces eléctricos dentro del rack con conexiones ópticas entre racks, de acuerdo con la arquitectura presentada por la compañía. El diseño de red pretende escalar desde un único rack hasta grandes agrupaciones de aceleradores. Microsoft contempla superpods de hasta 12.288 aceleradores repartidos en un máximo de 128 racks.
El tamaño de estas instalaciones ayuda a explicar por qué el consumo por unidad de trabajo es uno de los parámetros que Microsoft destaca en Maia 300. La empresa asegura que el sistema puede generar hasta siete veces más tokens por rack que Maia 200 en una configuración completa de 96 aceleradores. También calcula una mejora del 40 % en tokens por megavatio frente a sistemas basados en GPU que toma como referencia.
Ambas cifras son afirmaciones del fabricante, no garantías de rendimiento para cualquier modelo o aplicación. Los resultados reales pueden variar según la arquitectura del modelo, su longitud de contexto, la precisión numérica, la utilización de memoria y las condiciones de ejecución.
Maia 200 ya trabaja en producción y Maia 300 llegará en 2027
Microsoft distingue entre la infraestructura que ya utiliza y la próxima generación. Maia 200 está en producción y ejecuta cargas internas, entre ellas Microsoft Copilot, además de dar soporte al equipo que desarrolla los modelos propios MAI. La compañía también ha anunciado que GitHub Copilot y Microsoft Foundry incorporarán Maia 200 antes de que termine 2026.
La experiencia obtenida con Maia 200 ha servido para orientar el diseño de Maia 300. Microsoft cita como áreas de aplicación la asistencia a la programación, el alojamiento de modelos en la nube, la generación de datos para entrenar y desarrollar modelos, y las aplicaciones clínicas que utilizan Dragon Copilot.
La empresa sostiene que Maia 200 ofrece hasta 1,7 veces más tokens por vatio que la infraestructura de GPU de referencia en determinadas funciones de IA integradas en Microsoft Teams, Copilot y experiencias Cowork. Esta cifra corresponde a las cargas descritas por Microsoft y no debe confundirse con la comparación de Maia 300 por megavatio.
Los despliegues de Maia 300 comenzarán en 2027. Microsoft también prevé ampliar la familia Maia a una escala de varios gigavatios a partir de ese año, aunque el anuncio no proporciona un calendario detallado por centros de datos ni una distribución de la capacidad prevista por región.
La estrategia no implica que todos los servicios de Microsoft vayan a abandonar las GPU de otros fabricantes. El anuncio describe el objetivo de convertir Maia en el sistema principal de inferencia para los productos y servicios de la compañía, pero no establece una sustitución completa de los aceleradores externos.
Para los clientes de Azure, el desarrollo de Maia puede traducirse en más opciones de infraestructura para ejecutar modelos y aplicaciones de IA. El efecto sobre los precios, la disponibilidad o el rendimiento de los servicios dependerá de cómo Microsoft despliegue los nuevos sistemas y de las condiciones comerciales que ofrezca.
Preguntas frecuentes
¿Cuándo estará disponible Microsoft Maia 300?
Microsoft prevé comenzar los despliegues de Maia 300 en producción durante 2027. La compañía no ha publicado una fecha concreta de disponibilidad general para los clientes.
¿Qué memoria y ancho de banda tiene Maia 300?
Cada acelerador incorpora 288 GB de memoria HBM4 y alcanza hasta 18 TB/s de ancho de banda máximo. Un rack completo de 96 aceleradores suma 27,6 TB de memoria HBM.
¿Qué proceso de fabricación utiliza Maia 300?
Los chiplets de cálculo utilizan el proceso N2P de TSMC. El diseño separa el cálculo, los controladores de memoria y las funciones de entrada y salida en distintos chiplets.
¿Qué diferencia hay entre Maia 200 y Maia 300?
Maia 200 ya ejecuta cargas de producción de Microsoft, mientras que Maia 300 está diseñado para mejorar la inferencia en tareas con grandes necesidades de memoria y contexto. Microsoft afirma que Maia 300 puede alcanzar hasta siete veces más rendimiento de tokens por rack que Maia 200 en una configuración de 96 aceleradores.