Vulsar AI ha publicado un benchmark que pone a prueba la capacidad de 24 modelos de inteligencia artificial para escribir ficción y los compara con textos de escritores humanos. El estudio, basado en 475 prompts, sitúa a GPT 6 Astra con una tasa de victoria prevista del 87,8 % en la clasificación general, frente al 86,6 % de la referencia humana, aunque la diferencia cambia de forma importante al separar escritores profesionales y aficionados.
Las claves del benchmark de escritura creativa de Vulsar en 20 segundos
- Vulsar ha comparado 24 modelos de IA con escritores humanos mediante 475 prompts.
- GPT 6 Astra obtiene un 87,8 % de tasa de victoria prevista en el resultado general.
- Los escritores humanos alcanzan el 86,6 % en esa misma clasificación.
- Frente a escritores profesionales, Astra baja al 76,2 %, mientras la referencia humana llega al 99,9 %.
- Entre aficionados, Astra alcanza el 93,9 %, frente al 79,7 % de los escritores humanos.
El benchmark, publicado el 17 de septiembre de 2026, intenta medir una capacidad que resulta más difícil de comparar que las habituales pruebas de matemáticas, programación o conocimiento. Vulsar no busca determinar simplemente si un modelo puede producir un texto coherente, sino estimar qué historias tendrían más probabilidades de ser preferidas por lectores humanos.
La metodología utiliza un modelo de recompensa entrenado con preferencias humanas sobre escritura creativa. Vulsar no emplea otro modelo de lenguaje como juez final ni una rúbrica tradicional con varios criterios independientes. El sistema compara las respuestas y calcula una tasa de victoria prevista para cada participante.
GPT 6 Astra encabeza la clasificación general
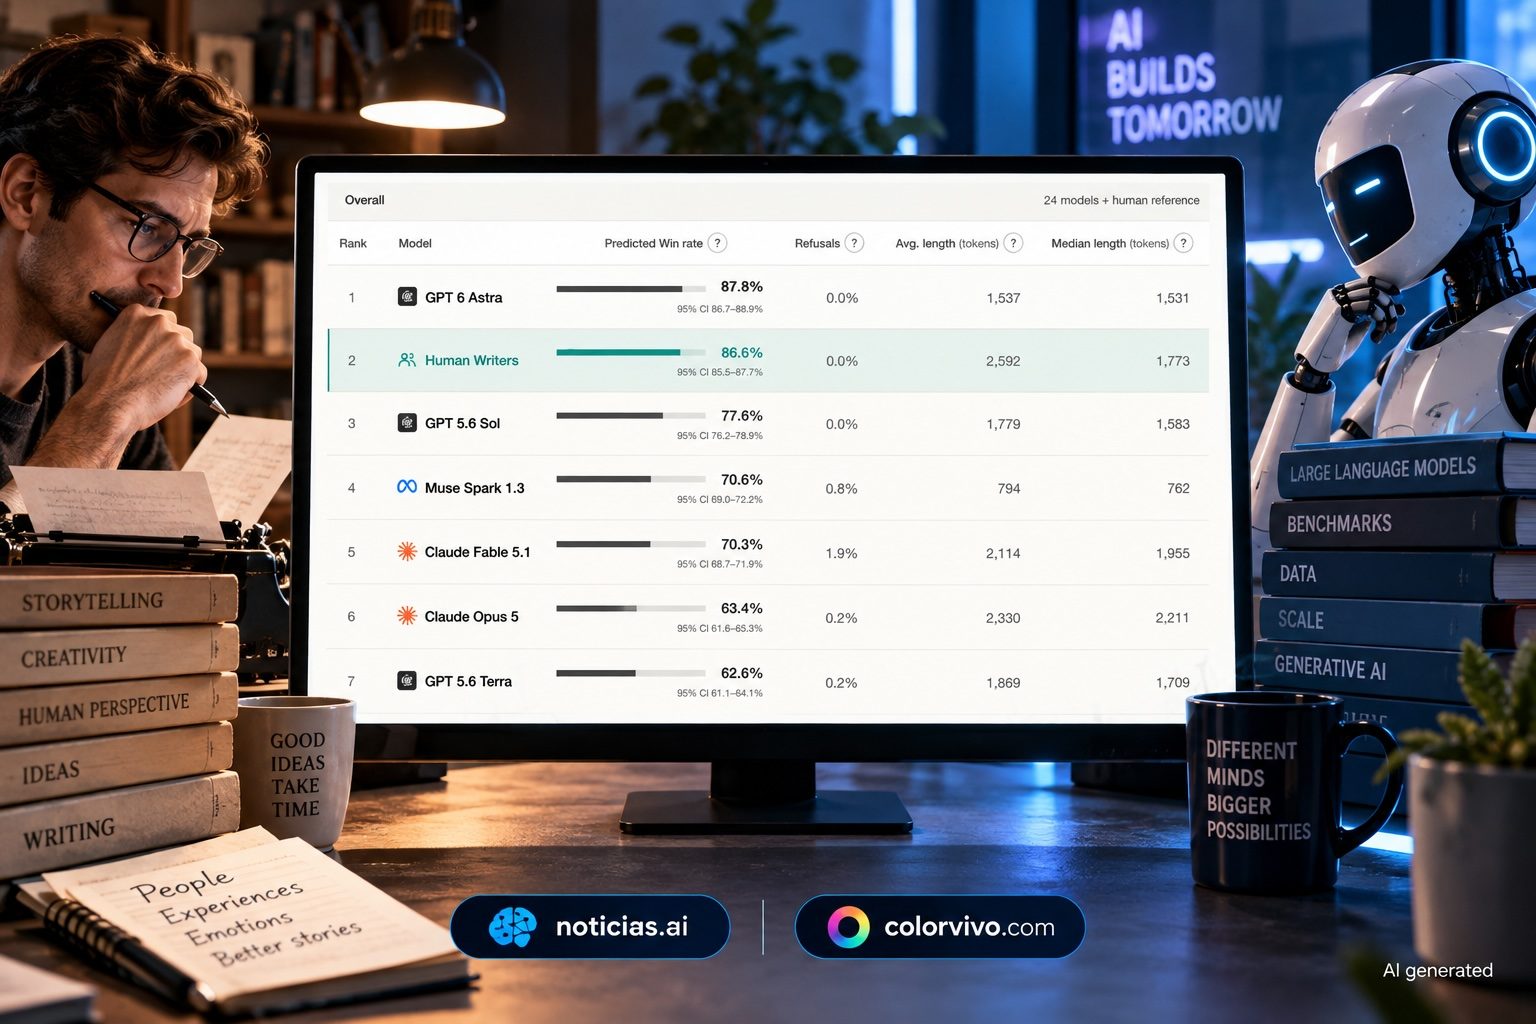
GPT 6 Astra obtiene un 87,8 % de tasa de victoria prevista, frente al 86,6 % de la referencia formada por escritores humanos. La diferencia es de 1,2 puntos porcentuales, dentro de un resultado que Vulsar presenta como una estimación de preferencia y no como una puntuación absoluta de calidad literaria.
| Posición | Modelo o referencia | Victoria prevista |
|---|---|---|
| 1 | GPT 6 Astra | 87,8 % |
| 2 | Escritores humanos | 86,6 % |
| 3 | GPT 5.6 Sol | 77,6 % |
| 4 | Muse Spark 1.3 | 70,6 % |
| 5 | Claude Fable 5.1 | 70,3 % |
| 6 | Claude Opus 5 | 63,4 % |
| 7 | GPT 5.6 Terra | 62,6 % |
| 8 | GPT 5.6 Luna | 61,8 % |
| 9 | Kimi K3 | 61,0 % |
| 10 | Grok 4.6 | 59,3 % |
Por debajo aparecen GLM 5.3 Flash, con un 54,6 %, Qwen3.8 2.4T A95B, con un 53,9 %, e Inkling, con un 52,3 %. En la parte inferior de la clasificación se encuentran Gemma 4 31B, con un 23,4 %, Qwen3.8 27B, con un 23,2 %, DeepSeek V4.1 Flash, con un 19,8 %, DeepSeek V3.2, con un 16,5 %, y Gemma 4 26B A4B, con un 10,9 %.
El estudio también registra diferencias en la longitud de las historias. Los escritores humanos generan una media de 2.592 tokens, mientras GPT 6 Astra se queda en 1.537. Claude Opus 5 alcanza 2.330 y Claude Fable 5.1 llega a 2.114.
La longitud, sin embargo, no se utiliza como criterio para establecer la clasificación. El benchmark está diseñado para medir la preferencia prevista por el modelo de recompensa de Vulsar.
Los escritores profesionales marcan una diferencia mucho mayor
El dato cambia de manera notable cuando el benchmark separa a los escritores profesionales. En esta categoría, la referencia humana obtiene una tasa de victoria prevista del 99,9 %. GPT 6 Astra registra un 76,2 %, mientras Grok 4.6 alcanza el 78,5 %.
| Posición | Modelo o referencia | Victoria prevista |
|---|---|---|
| 1 | Escritores profesionales | 99,9 % |
| 2 | Grok 4.6 | 78,5 % |
| 3 | GPT 6 Astra | 76,2 % |
| 4 | Claude Fable 5.1 | 69,8 % |
| 5 | Muse Spark 1.3 | 64,9 % |
| 6 | Qwen3.8 2.4T A95B | 63,6 % |
| 7 | Claude Opus 5 | 63,3 % |
| 8 | GPT 5.6 Sol | 63,1 % |
La distancia entre los modelos y los autores profesionales es todavía más visible al observar la longitud de los textos. Los escritores profesionales alcanzan una media de 4.528 tokens por historia, frente a los 1.745 de GPT 6 Astra.
Vulsar explica que los prompts utilizados con profesionales incluyen instrucciones más detalladas y requisitos específicos. Por eso esta parte del benchmark no debe interpretarse simplemente como una repetición de la clasificación general con otro grupo de participantes.
La comparación muestra que el rendimiento de un modelo puede variar según el tipo de tarea y el nivel de experiencia de la referencia humana. Una clasificación global puede ocultar esas diferencias.
Los modelos obtienen mejores resultados frente a aficionados
La categoría de escritores aficionados ofrece una fotografía diferente. GPT 6 Astra alcanza una tasa de victoria prevista del 93,9 %, GPT 5.6 Sol obtiene un 85,2 % y la referencia de escritores aficionados se sitúa en el 79,7 %.
| Posición | Modelo o referencia | Victoria prevista |
|---|---|---|
| 1 | GPT 6 Astra | 93,9 % |
| 2 | GPT 5.6 Sol | 85,2 % |
| 3 | Escritores aficionados | 79,7 % |
| 4 | Muse Spark 1.3 | 73,5 % |
| 5 | Claude Fable 5.1 | 70,5 % |
| 6 | GPT 5.6 Terra | 70,2 % |
| 7 | GPT 5.6 Luna | 67,4 % |
| 8 | Claude Opus 5 | 63,5 % |
La diferencia entre esta categoría y la profesional es uno de los aspectos más relevantes del estudio. GPT 6 Astra pasa de un 93,9 % frente a aficionados a un 76,2 % frente a profesionales.
El resultado tampoco permite convertir el benchmark en una respuesta general sobre si la inteligencia artificial escribe mejor que las personas. La comparación depende del conjunto de prompts, de la referencia utilizada y del sistema empleado para estimar las preferencias.
475 prompts para medir una capacidad difícil de comparar
Vulsar utilizó 475 prompts únicos y pidió a los participantes generar una historia corta para cada tarea. Las pruebas abarcan distintos tipos de ficción y utilizan las mismas instrucciones para los modelos dentro de cada conjunto de evaluación.
La compañía desactivó el razonamiento cuando el modelo ofrecía esa posibilidad. Cuando no podía hacerlo, utilizó el nivel de razonamiento disponible más bajo. Las respuestas vacías y los rechazos no se contabilizan automáticamente como derrotas, sino que quedan fuera de las comparaciones correspondientes.
Este detalle importa porque la tasa de victoria de Vulsar no equivale a un porcentaje de aciertos. Un 87,8 % significa que, dentro del conjunto de comparaciones del benchmark, el sistema de evaluación estima una preferencia favorable hacia las respuestas de GPT 6 Astra en ese porcentaje.
Además, los intervalos de confianza aportan información adicional. Para GPT 6 Astra, Vulsar sitúa el intervalo de confianza del 95 % entre el 86,7 % y el 88,9 %. Para la referencia humana general, el intervalo se encuentra entre el 85,5 % y el 87,7 %.
El benchmark no mide originalidad de forma independiente
Vulsar también reconoce una limitación relacionada con la originalidad. Su modelo de recompensa ha sido entrenado con preferencias humanas que pueden valorar la sensación de novedad de una historia, pero el benchmark no comprueba de forma independiente si las ideas o formulaciones de los textos son realmente nuevas respecto a obras existentes o a los datos de entrenamiento de los modelos.
Por eso una tasa de victoria elevada no debe interpretarse como una certificación de originalidad.
La misma cautela se aplica a la calidad literaria. El benchmark pretende estimar preferencias humanas agregadas, no establecer una medida universal de calidad. Los gustos individuales pueden diferir de la predicción del modelo de recompensa.
Para la evaluación de los modelos de IA, el estudio resulta especialmente útil porque introduce una dimensión que no aparece habitualmente en los benchmarks técnicos: la comparación entre generación automática y preferencias humanas sobre una tarea abierta.
Los resultados muestran además que el rendimiento no se distribuye de la misma manera cuando cambia el nivel de los escritores de referencia. GPT 6 Astra se sitúa prácticamente al nivel de la referencia humana general, supera a la referencia de aficionados y queda bastante más lejos de los escritores profesionales dentro de las métricas publicadas por Vulsar.
Eso convierte el Creative Writing Bench V1 en una prueba concreta sobre escritura creativa, pero no en una medición general de las capacidades de los modelos de lenguaje.
Preguntas frecuentes
¿Qué modelos participan en el benchmark de Vulsar?
Vulsar compara 24 modelos de inteligencia artificial con referencias de escritores humanos utilizando 475 prompts de escritura creativa. La clasificación incluye modelos de distintas familias y tamaños.
¿Qué resultado obtiene GPT 6 Astra?
GPT 6 Astra alcanza un 87,8 % de tasa de victoria prevista en la clasificación general. Frente a escritores profesionales obtiene un 76,2 % y frente a aficionados llega al 93,9 %.
¿Cómo evalúa Vulsar las historias?
Vulsar utiliza un modelo de recompensa entrenado con preferencias humanas sobre escritura creativa. No utiliza otro LLM como juez final ni una rúbrica tradicional de puntuación.
¿El benchmark demuestra que la IA escribe mejor que los humanos?
No establece una conclusión general de ese tipo. El estudio mide una preferencia prevista dentro de 475 tareas concretas y los resultados cambian de forma importante según se compare con escritores profesionales o aficionados.